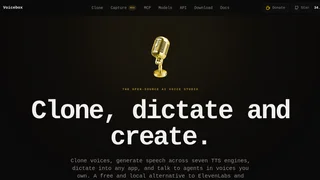
Voicebox は、macOS、Windows、および Linux 上のデスクトップ環境向けに設計された、ローカルファーストでオープンソースの AI 音声スタジオです。クラウドベースの音声プラットフォームに代わる、プライバシーを尊重し、コスト効率の高い選択肢として構築されており、開発者、コンテンツクリエイター、およびプライバシー擁護派が、完全にローカルハードウェア上で音声をクローンし、テキスト読み上げオーディオを生成し、ファイルを書き起こし、パーソナライズされた音声を使用して AI エージェントと対話できるようにします。モデルをローカルで実行することにより、Voicebox は、クラウド音声合成プラットフォームに関連する継続的なサブスクリプション料金、文字ごとの API コスト、およびデータ共有に関する懸念を排除します。
主な機能
- ゼロショット音声クローニング: わずか 3 秒の参照オーディオサンプルを使用して高度にリアルな音声レプリカを合成し、広範なトレーニングなしでカスタム音声を迅速にセットアップできます。
- マルチエンジン音声生成: Kokoro や Qwen3-TTS を含む 7 つの異なるオープンソーステキスト読み上げエンジンを統合し、発話速度、発音のニュアンス、および感情的なトーンをユーザーが制御できるようにします。
- システム全体のディクテーション: デスクトップ上の任意のテキスト入力領域またはアクティブなアプリケーションに、即座にシステム全体の音声文字変換を直接入力できるグローバルホットキーショートカットを備えています。
- マルチトラックオーディオエディター: 複数の音声トラックのレイヤリング、会話の配置、オーディオクリップのトリミング、および複数音声のナレーションのエクスポートをサポートするタイムラインベースのエディターが含まれています。
- ローカル推論と加速: macOS 用の Metal や Windows および Linux 用の CUDA を含むローカルマシンのハードウェアアクセラレーションを活用して、クラウド API なしで低レイテンシの音声を生成します。
- Whisper を搭載した文字起こし: OpenAI の Whisper モデルを利用して、インポートされたオーディオファイルや音声録音に対して正確なオフライン音声文字変換を提供します。
- ローカル REST API: ポート 17493 で実行される開発者フレンドリーなローカルサーバーを公開し、スクリプト、カスタムアプリケーション、およびサードパーティソフトウェアが音声合成エンドポイントをクエリできるようにします。
音声ライブラリとクローニング
プラットフォームは、インポートされた音声サンプルと生成されたクローンの両方を処理する統合音声マネージャーを中心に展開します。ユーザーはマルチサンプル入力を使用して音声をクローンできます。これにより、ターゲット音声の複数のオーディオファイルを統合して、発音とトーンの安定性を微調整します。Voicebox は合成されたオーディオチャンクをインテリジェントにキャッシュし、冗長な処理を防ぎ、その後の同じテキストの再生を高速化します。システムは、個々の音声エンジンのペース、ピッチ、およびトーンの調整もサポートしており、ユーザーが特定のキャラクタープロファイルや音声スタイルに合わせて音声出力を微調整できるようにします。
デスクトップアプリとローカル推論
デスクトップアプリケーションとして、Voicebox は最大限のオフライン能力を実現するように設計されています。インストールパッケージは macOS、Windows、および Linux で利用できます。アプリケーションは、さまざまな TTS および音声文字変換モデルの AI 重みのダウンロードを管理し、ユーザーのアプリケーションディレクトリにローカルに保存します。ダウンロードされると、すべての合成および文字起こしタスクはインターネット接続なしで行われます。互換性のあるハードウェアでリアルタイム生成を可能にする、GPU 機能にアクセスするネイティブバインディングを介してパフォーマンスが最適化されます。ユーザーは、計算負荷の高い処理をローカルサーバーまたは外部 GPU クラスターにオフロードしたい場合、リモート推論サーバーを構成することもできます。
価格とライセンス
Voicebox は、オープンソースライセンスのもとで完全に無料でダウンロードして使用できます。ソースコードは GitHub で公開されており、開発者はアプリケーションを検査、変更、およびセルフホストできます。すべての AI モデルはユーザーの CPU または GPU でローカルに実行されるため、文字生成の制限、API アクセス料金、または使用量ベースの価格プランはありません。ユーザーはアカウントを登録したり、支払い情報を提供したりする必要はありません。クリエイターへのオプションのサポートはコミュニティの寄付プラットフォームを通じて促進されますが、コアソフトウェアとすべての標準機能は引き続き無料です。
メリットとデメリット
メリット:
- Completely free and open-source with no recurring subscription or per-character generation fees.
- プライバシー優先のローカル実行により、機密性の高い音声データや文字起こしされたテキストがホストマシン上で安全に保たれます。
- 単一の統一されたデスクトップインターフェースのもとで、複数のテキスト読み上げエンジンを統合します。
- 開発者ワークフローおよび自動音声統合用に、MCP サーバーとローカル REST API の両方を公開します。
デメリット:
- 低レイテンシの生成には、GPU アクセラレーションを備えた比較的最新のデスクトップハードウェアが必要です。
- 複数の重い AI モデルの重みをダウンロードしてキャッシュするため、ローカルストレージのフットプリントが大きくなります。
- クラウドベースの同期がないため、デバイス間で音声ライブラリと設定を手動で移動する必要があります。
Voicebox を使用すべきユーザー
Voicebox は、信頼性の高いオフライン優先の音声合成ツールを必要とするソフトウェア開発者、プライバシーを意識するコンテンツクリエイター、および自動化愛好家に最適です。音声フィードバックを IDE、ターミナル、またはローカルスクリプトワークフローに統合したい開発者に特に適しています。ただし、古いデスクトップコンピュータや低スペックのラップトップを実行しているユーザーは生成速度が遅くなる可能性があり、専用のグラフィックスハードウェアや最新のプロセッサを搭載していないユーザーには適していません。