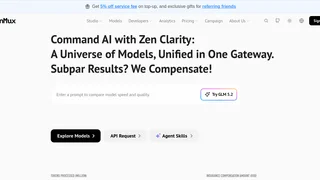
Zenmux AI は、開発者、ソフトウェアエンジニア、および企業が AI アプリケーションを簡単にデプロイできるように設計された、エンタープライズグレードの AI モデル集約プラットフォームおよび大規模言語モデル(LLM)ゲートウェイです。Web ダッシュボードと単一の統合 API エンドポイントを通じて利用可能であり、OpenAI、Anthropic、Google、DeepSeek、Meta などのトップクラスのプロバイダーから 200 以上の主要な言語モデルを単一の請求アカウントに統合します。Zenmux AI は、マルチベンダーの API の複雑さを回避し、レイテンシを削減し、トークンベースのインフラストラクチャコストを制御したい開発チーム向けに特別に構築されています。
このプラットフォームは、ソフトウェアアプリケーションとさまざまな AI プロバイダーの間のインテリジェントな中間層として機能します。標準の OpenAI API 形式と完全に互換性があるようにリクエストを標準化することで、Zenmux AI は開発者がコードベースを変更することなくモデルを交換したり、フォールバック戦略を実行したりできるようにします。統合を簡素化し、自動化されたパフォーマンス保証を提供することにより、プラットフォームはスタートアップとエンタープライズチームの両方にとって生産品質の AI デプロイを身近なものにします。
主な機能
- 統合された AI API ゲートウェイ: OpenAI、Anthropic、Google などのプロバイダーからの 200 以上の大規模言語モデルに、単一の OpenAI 互換 API キーを使用してアクセスします。
- インテリジェントな LLM ルーティング: コスト、応答レイテンシ、および出力品質の要件に基づいて、リクエストを最適なモデルに自動的にルーティングします。
- AI モデル保険: モデルが高レイテンシ、障害、または基準を下回る出力品質に悩まされた場合、アカウントクレジットでユーザーに自動的に補償します。
- マルチベンダーのコスト管理: すべての請求、トークン使用量、および API キーを単一のインターフェースに統合し、管理上の複雑さを排除します。
- リアルタイム分析ダッシュボード: 接続されているすべてのモデルのコスト、レイテンシ、スループット、およびトークン消費を、多次元の可視化グラフで追跡します。
- ハルシネーション検出: 潜在的なハルシネーション(もっともらしい嘘)や低品質の応答を監視してフラグを立て、本番環境の信頼性を維持します。
- 高並列スケーラビリティ: ローカルのレート制限なしで本番グレードのスケーリングをサポートし、アプリケーションが重い並行リクエストロードを処理できるようにします。
インテリジェントルーティングとフェイルオーバーエンジン
Zenmux AI の中心となるのは、着信プロンプトを評価し、最適なモデルに自動的にルーティングするスマートルーティングエンジンです。ユーザーは、トークンコストの最小化や応答時間の短縮の優先など、特定の優先事項に基づいてカスタムルーティングポリシーを定義できます。プライマリモデルで障害や一時的なレイテンシの急増が発生した場合、ゲートウェイはすぐにリクエストを事前構成されたバックアップモデルに切り替えます。この自動フェイルオーバー機能により、ユーザー向けアプリケーションの応答性と信頼性が維持されます。プラットフォームは独自の AI 保険も提供しており、モデルが確立された速度または品質の指標を下回った場合、ユーザーのアカウントにクレジットを払い戻すことで、プロバイダーのパフォーマンス責任を担保します。
開発者統合とスケーラビリティ
Zenmux AI は開発者ファーストのアプローチで構築されており、既存のソフトウェア開発キット (SDK) とのシームレスな統合を提供します。API は標準の OpenAI ヘッダーと完全に互換性があるため、開発者は単一のベース URL を変更するだけでプラットフォームをアプリケーションに統合できます。開発者ダッシュボードは、デバッグ用の詳細なログ、トークン使用量の内訳、およびプロンプトテンプレートの最適化に役立つ分析を提供します。本番環境では、プラットフォームは動的にスケールして高並列をサポートし、個別プロバイダーのアカウントに関連付けられた厳しいレート制限を回避しながら、一貫したスループットを維持します。
料金と購読プラン
Zenmux AI は、開発とテスト向けに設計された購読プランを備えたフリーミアムモデルと、実用本番デプロイ向けの従量課金制(Pay-As-You-Go)モデルで運営されています。
| プラン | 価格 | モデルクォータ / フロー制限 | 主な機能 |
|---|
| Free | $0 | 制限されたアクセス、標準レイテンシ | 選択された無料/フラッシュモデル、標準監視ダッシュボード。 |
| Pro | $20/月 | 約100モデル、基本的なレイテンシ保険 | 個人開発機能、基本的なレイテンシ補償。 |
| Max | $100/月 | 高度なビデオ/プロモデル、ハルシネーション補償 | ハルシネーション保険、優先ルーティング、プロモデルアクセス。 |
| Ultra | $400/月 | 完全なモデルサポート、SLA保証 | 最大スループット、専用SLA、優先技術サポート。 |
本番デプロイの場合、ユーザーは従量課金制モデルに移行できます。このモデルは、トークンレベルの正確な請求、無制限のスケーリング、および高並列サポートを備えています。プラットフォームは紹介プログラムも提供しており、招待されたユーザーがチャージすると紹介者に5ドルのクレジットが付与され、新規ユーザーは最初のデポジットで5%のボーナスを受け取ります。
メリットとデメリット
メリット:
- 200以上のモデルを単一のAPIと請求ダッシュボードに統合。
- モデル応答が遅いか基準以下の品質の場合、アカウントに補償クレジットを付与する独自のAI保険。
- OpenAI互換のエンドポイントにより、コードを変更せずにモデルを簡単に交換可能。
- 高並列サポートと厳格なレート制限の排除により、エンタープライズ規模の拡張が容易。
- 詳細な分析ダッシュボードにより、モデルパフォーマンスの最適化とコスト削減を支援。
デメリット:
- 活発な開発フェーズにおいて、購読プランのクォータ制限がきつく感じられる場合がある。
- 自動ルーティングを特定のワークフローに合わせて調整する初期キャリブレーションが必要。
- 単一モデルのチャットアシスタントのみを必要とする一般ユーザーには過剰。
- エンタープライズ利用では、最適なスケーリングのために従量課金制モデルへの移行が必要。
- ハルシネーション補償の特典は、上位の購読プランに制限されている。
Zenmux AI を使用すべきユーザー
Zenmux AI は、AI アプリケーションをスケーリングしており、複数のモデルプロバイダーを管理する必要がある開発者、SaaS チーム、およびエンタープライズビルダーに最適です。インテリジェントなルーティング、フェイルオーバーメカニズム、および一元化された請求により、開発および運用のオーバーヘッドが大幅に削減されます。個別プロバイダーのアカウントを管理することなく、複数のモデルで迅速にプロトタイプを作成したいスタートアップにとっても優れた選択肢です。
しかし、ChatGPT のような単純なチャットインターフェースのみを必要とする一般ユーザーや個人ユーザーには、Zenmux AI は適していません。単一のモデルのみに依存し、すでにプロバイダーと直接的な関係を構築しているチームにとっても、ルーティングや保険レイヤーは不要に感じられる場合があります。