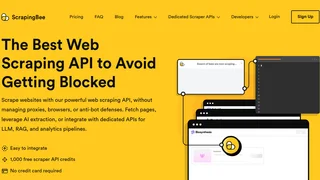
ScrapingBee 는 개발자가 자체 스크래핑 인프라를 구축하고 관리하는 번거로움 없이 웹사이트에서 데이터를 추출할 수 있도록 프록시 우회, 헤드리스 브라우저 렌더링, 안티봇 우회 기술을 처리해 주는 웹 스크래핑 API입니다. 시장조사, 이커머스 가격 모니터링, AI 데이터셋 학습, 리드 정보 수집 등 대규모의 안정적인 웹 데이터 수집이 필요한 개발자, 제품 기획 팀, 데이터 엔지니어를 위해 개발되었습니다.
핵심 기능
- 프록시 로테이션 HTML API: 한 번의 API 호출로 모든 공개 웹사이트의 생 HTML 소스를 가져옵니다. ScrapingBee가 주거용 및 스텔스 프록시 IP를 자동으로 순환하고, 캡차(CAPTCHA)를 풀며, 전송 실패 시 자동 재시도를 처리하므로 개발자가 프록시를 직접 관리할 필요가 없습니다.
- JavaScript 렌더링 지원: 클라이언트 사이드 렌더링(CSR) 방식의 웹 페이지를 긁어오기 위해 헤드리스 Chrome 브라우저를 구동합니다. 특정 셀렉터 대기, 커스텀 JS 스크립트 실행, 클릭 및 폼 입력 수행, 렌더링 화면 스크린샷 캡처 등을 지원합니다.
- AI 기반 데이터 추출: JSON 형식으로 데이터 정제 규칙을 입력하거나 AI Query 기능을 통해 자연어로 원하는 항목을 서술해 주면, 사이트마다 별도 파서를 작성할 필요 없이 정제된 JSON 데이터 또는 마크다운 형식으로 데이터를 즉시 반환합니다.
- 전용 수집기 API 제공: 구글 검색, 아마존, 유튜브, 월마트, ChatGPT 채널을 위한 빌트인 API 엔드포인트를 제공하여 번거로운 정제 작업 없이 바로 사용할 수 있는 정형 데이터를 돌려줍니다. Fast Search API는 1초 미만으로 실시간 검색 순위(SERP) 결과를 전달합니다.
- CLI 및 MCP 서버 지원: 터미널 CLI 명령어 및 Model Context Protocol (MCP) 서버를 기본 제공하여 Claude, ChatGPT, Cursor, Gemini와 같은 AI 코딩 툴과 스크래핑 프로세스를 직접 연동할 수 있습니다.
- 노코드(No-code) 자동화 연동: Make, n8n, Zapier용 네이티브 커넥터를 탑재하여 비개발자 직군도 코드를 한 줄 쓰지 않고 드래그 앤 드롭으로 웹 데이터 수집 자동화 흐름을 설정할 수 있습니다.
요금 정책
ScrapingBee 는 크레딧 기반의 정액제 월간 요금제를 제공합니다. 일반적인 정적 HTML 수집 요청은 1크레딧을 차감하지만 JS 렌더링, 프리미엄 프록시 우회, AI 데이터 추출 기능 활성화 시 추가 크레딧이 소모됩니다. 신규 회원가입 시 카드 등록 없이 1,000개의 테스트용 크레딧을 무료로 제공합니다.
| 요금제 | 월 가격 | 제공 크레딧/월 | 최대 동시 요청수 |
|---|
| Freelance | $49 | 250,000 | 50 |
| Startup | $99 | 1,000,000 | 100 |
| Business | $249 | 3,000,000 | 200 |
| Business+ | $599 | 8,000,000 | 400 |
| Custom | 별도 조율 | 별도 조율 | 별도 조율 |
모든 요금에는 부가세(VAT)가 포함되어 있지 않습니다. 월 중간에 상위 등급 요금제로 즉시 업그레이드하거나 조기 갱신할 수 있고 일회성 크레딧 충전 팩 구매도 지원합니다. ScrapingBee는 HTTP 200, 404, 410 등 최종 성공 처리된 호출 건에 대해서만 크레딧을 부과합니다.
전용 API 및 연동
일반 HTML API 외에도 널리 쓰이는 데이터 소스를 위해 전용 엔드포인트를 제공합니다. Google Search API는 검색 결과, 광고 리스트, 뉴스, 구글 맵 데이터를 반환합니다. Amazon 및 Walmart API는 상품 목록, 단가, 리뷰 정보를 구조화하여 제공합니다. YouTube API는 영상 메타데이터, 댓글, 자막 전사본을 수집합니다. ChatGPT API는 정형 분석을 위해 ChatGPT 모델의 응답 데이터를 규격화하여 모니터링하기 쉽게 모아 줍니다.
장점과 단점
장점:
- 인프라 관리 제로: 프록시 IP, 헤드리스 브라우징, 안티봇 차단 등이 단일 API 뒤로 추상화되어 있어 신경 쓸 필요가 없습니다.
- AI 추출 기술을 활용하여 웹사이트가 리뉴얼되어도 별도의 파서 수정 없이 자연어 질의만으로 정확한 JSON 결과물을 받아볼 수 있습니다.
- 구글, 아마존, 유튜브 등 트래픽이 높은 거대 플랫폼 수집 전용 API가 이미 있어 개발 기간을 대폭 축소해 줍니다.
- SOC 2 Type 2 및 GDPR 규정을 통과하여 대기업 조달 보안 검토 시 유리합니다.
단점:
- JS 렌더링, 고급 프록시 우회, AI 처리를 활성화할 경우 호출당 차감 크레딧이 급증하여 복잡한 수집 시 예산 부담이 늘어날 수 있습니다.
- 월 $49의 Freelance 요금제에서는 JS 렌더링과 프리미엄 프록시를 지원하지 않아, 보안 장벽이 높은 웹사이트 수집에는 제약이 따릅니다.
- 전용 API 대상이 아닌 커스텀 사이트를 스크래핑할 때는 일반 HTML API 호출 후 직접 파싱 작업을 수행해야 합니다.
추천 고객
대량의 웹 데이터 수집이 필요하지만 복잡한 프록시 우회 및 헤드리스 브라우저 서버 인프라를 직접 운영하고 싶지 않은 개발팀에 이상적입니다. 이커머스 시세 모니터링, AI 학습용 원천 데이터 구축, 리드 정보 추출 파이프라인 개발에 강력합니다. Make나 n8n 같은 노코드 플랫폼과 결합하여 비즈니스 자동화 워크플로를 구축하려는 팀에게도 ScrapingBee는 훌륭한 선택지입니다.