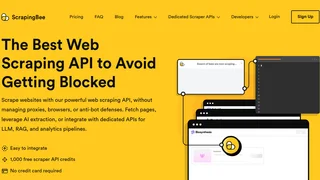
ScrapingBee 是一款网页抓取 API,可处理代理、无头浏览器和反爬虫对策,使开发人员能够从网站提取数据,而无需构建和维护自己的抓取基础设施。它专为在大规模场景下需要可靠网页数据的开发人员、产品团队和数据工程师而构建,适用于市场情报、电子商务监控、AI 训练和线索丰富等使用场景。
关键功能
- 支持代理旋转的 HTML API: 在单次 API 调用中从任何公开网站获取原始 HTML。ScrapingBee 会自动旋转住宅和隐身代理、处理验证码并管理重试,因此您无需管理自己的代理集群即可获得干净的页面内容。
- JavaScript 渲染: 对于依赖客户端渲染的页面,ScrapingBee 运行无头 Chrome,支持等待选择器、执行自定义 JavaScript 场景、点击元素、填写表单并捕获渲染输出的屏幕截图。
- AI 驱动的数据提取: 在 JSON 中定义提取规则,或使用 AI Query(AI 查询)以自然语言描述您需要的字段。ScrapingBee 会返回结构化的 JSON 或干净的 Markdown,而无需为每个目标网站编写自定义解析器。
- 专用抓取工具 API: 针对 Google 搜索、亚马逊、YouTube、沃尔玛和 ChatGPT 的预建端点返回结构化、开箱即用的数据,无需自定义解析。快速搜索 API 可在不到一秒的时间内交付实时 SERP 结果。
- CLI 和 MCP 服务器: 命令行界面和模型上下文协议服务器让 Claude、ChatGPT、Cursor 和 Gemini 等 AI 编码工具能够直接运行抓取工作流程。技能包为常见的抓取任务提供预建的自动化功能。
- 无代码和低代码集成: 针对 make、n8n 和 Zapier 的原生连接器让非开发人员能够将网页抓取放入自动化工作流程中,而无需编写代码。
定价与计划
ScrapingBee 提供按月计费的订阅计划,每个计划都包含固定数量 of API 积分。基本请求消耗一个积分,而 JavaScript 渲染、高级代理或 AI 提取等功能会消耗额外的积分。新用户可获得 1,000 个免费积分,无需信用卡。
| 计划 | 价格 | 积分/月 | 并发请求数 |
|---|
| Freelance | $49 | 250,000 | 50 |
| Startup | $99 | 1,000,000 | 100 |
| Business | $249 | 3,000,000 | 200 |
| Business+ | $599 | 8,000,000 | 400 |
| Custom | 定制 | 定制 | 定制 |
所有价格均不含增值税。如果在下一个计费周期之前用完,用户可以在周期中升级计划、提前续订或购买一次性积分附加包。ScrapingBee 仅对成功的请求收费,成功的请求定义为返回 HTTP 200、404 或 410 状态码的请求。
专用 API 和集成
除了通用的 HTML API 之外,ScrapingBee 还为热门数据源提供专用端点。Google 搜索 API 返回自然搜索结果、广告、新闻和地图。亚马逊和沃尔玛 API 交付商品列表、价格和评价数据。YouTube API 呈现视频元数据、评论和转录文本。ChatGPT API 以结构化格式收集模型响应以进行分析和监控。
对于已经使用自动化平台的团队,ScrapingBee 与 make、n8n 和 Zapier 进行原生集成。开发人员还可以使用 MCP 服务器让 AI 编码助手直接访问抓取功能,或使用 CLI 从终端编写抓取工作流程脚本。
优缺点
优点:
- 无需管理基础设施:代理、浏览器、验证码和反爬虫处理全部被抽象到单个 API 背后。
- AI 提取减少了对每个网站解析逻辑的需求,从自然语言查询返回结构化 JSON。
- 针对 Google、亚马逊、YouTube、沃尔玛和 ChatGPT 的专用 API 节省了常见数据源的开发时间。
- SOC 2 Type 2 合规性和 GDPR 准备就绪,使其适合企业采购。
- 1,000 个积分的免费层让开发人员可以在承诺付费计划之前测试服务。
- CLI 和 MCP 服务器使 AI 编码助手和终端环境能够支持 AI 辅助的抓取工作流程。
缺点:
- JavaScript 渲染、高级代理和 AI 提取每次请求会消耗更多积分,这可能会增加复杂抓取作业的成本。
- 每月 49 美元的 Freelance 计划缺乏 JavaScript 渲染和高级代理支持,限制了其在具有强反爬虫保护的网站上的实用性。
- 专用 API 仅限于固定的数据源集;抓取自定义或利基网站仍需要通用的 HTML API 和自定义解析。
- 并发请求限制与计划层级绑定,这可能会在较低层级计划中使高容量或时间敏感的抓取工作流程遇到瓶颈。
谁应该使用 ScrapingBee
ScrapingBee 非常适合需要大规模可靠网页数据但不想构建和维护自己的代理旋转、无头浏览器集群和反爬虫基础设施的开发团队。它非常适合电子商务价格监控、市场情报收集、AI 和 LLM 数据管道以及线索丰富工作流程。已经使用无代码自动化平台的团队将受益于 make、n8n 和 Zapier 的集成。
该服务不太适合预算非常紧且主要抓取简单静态页面的团队,因为入门级的 Freelance 计划不包含高级代理和 JavaScript 渲染。对于需要抓取专用 API 未覆盖的源,且自定义解析工作是主要瓶颈(而不是基础设施管理)的项目,它也可能不是最佳选择。